Étude de cas 02 / 06
Bulq.ai
BTP · IA
Du no-code à une véritable plateforme logicielle
- Ingénierie des données
- Ingénierie logicielle
- Cloud et infrastructure
Chiffres clés
- Devis fournisseurs aux formats hétérogènes
- Des milliers
- Dépense LLM du pipeline refondu
- Plafonnée
- Cycle de rattrapage du pipeline refondu
- 5 min
En bref
L’enjeu
Un produit de chiffrage par IA pour les entreprises du BTP, enfermé dans un front no-code WeWeb, avec des milliers de devis fournisseurs aux formats hétérogènes à transformer en prix structurés, et des consultations fournisseurs encore suivies à la main.
Notre réalisation
La plateforme d’extraction de devis par IA qui transforme les devis fournisseurs des clients en prix structurés et validés ; les fondations du backend-for-frontend FastAPI qui a permis à Bulq.ai de quitter WeWeb client par client ; et S2C, un back-end de consultation fournisseurs automatisée. Le tout conçu pour la migration de Bulq.ai vers son propre environnement Google Cloud.
Le résultat
Une plateforme maîtrisée et testée : un pipeline d’extraction refondu, conçu pour se rétablir seul après une panne et contenir les dépenses LLM sous plafond, avec une validation humaine réservée aux cas qui demandent du discernement, ainsi qu’un back-end testé pour les consultations fournisseurs automatisées.
Services associés : Développement full stackCollecte et analyse de donnéesInfrastructure cloud
Savoir-faire
Ce qu’il a fallu.
Ingénierie des données
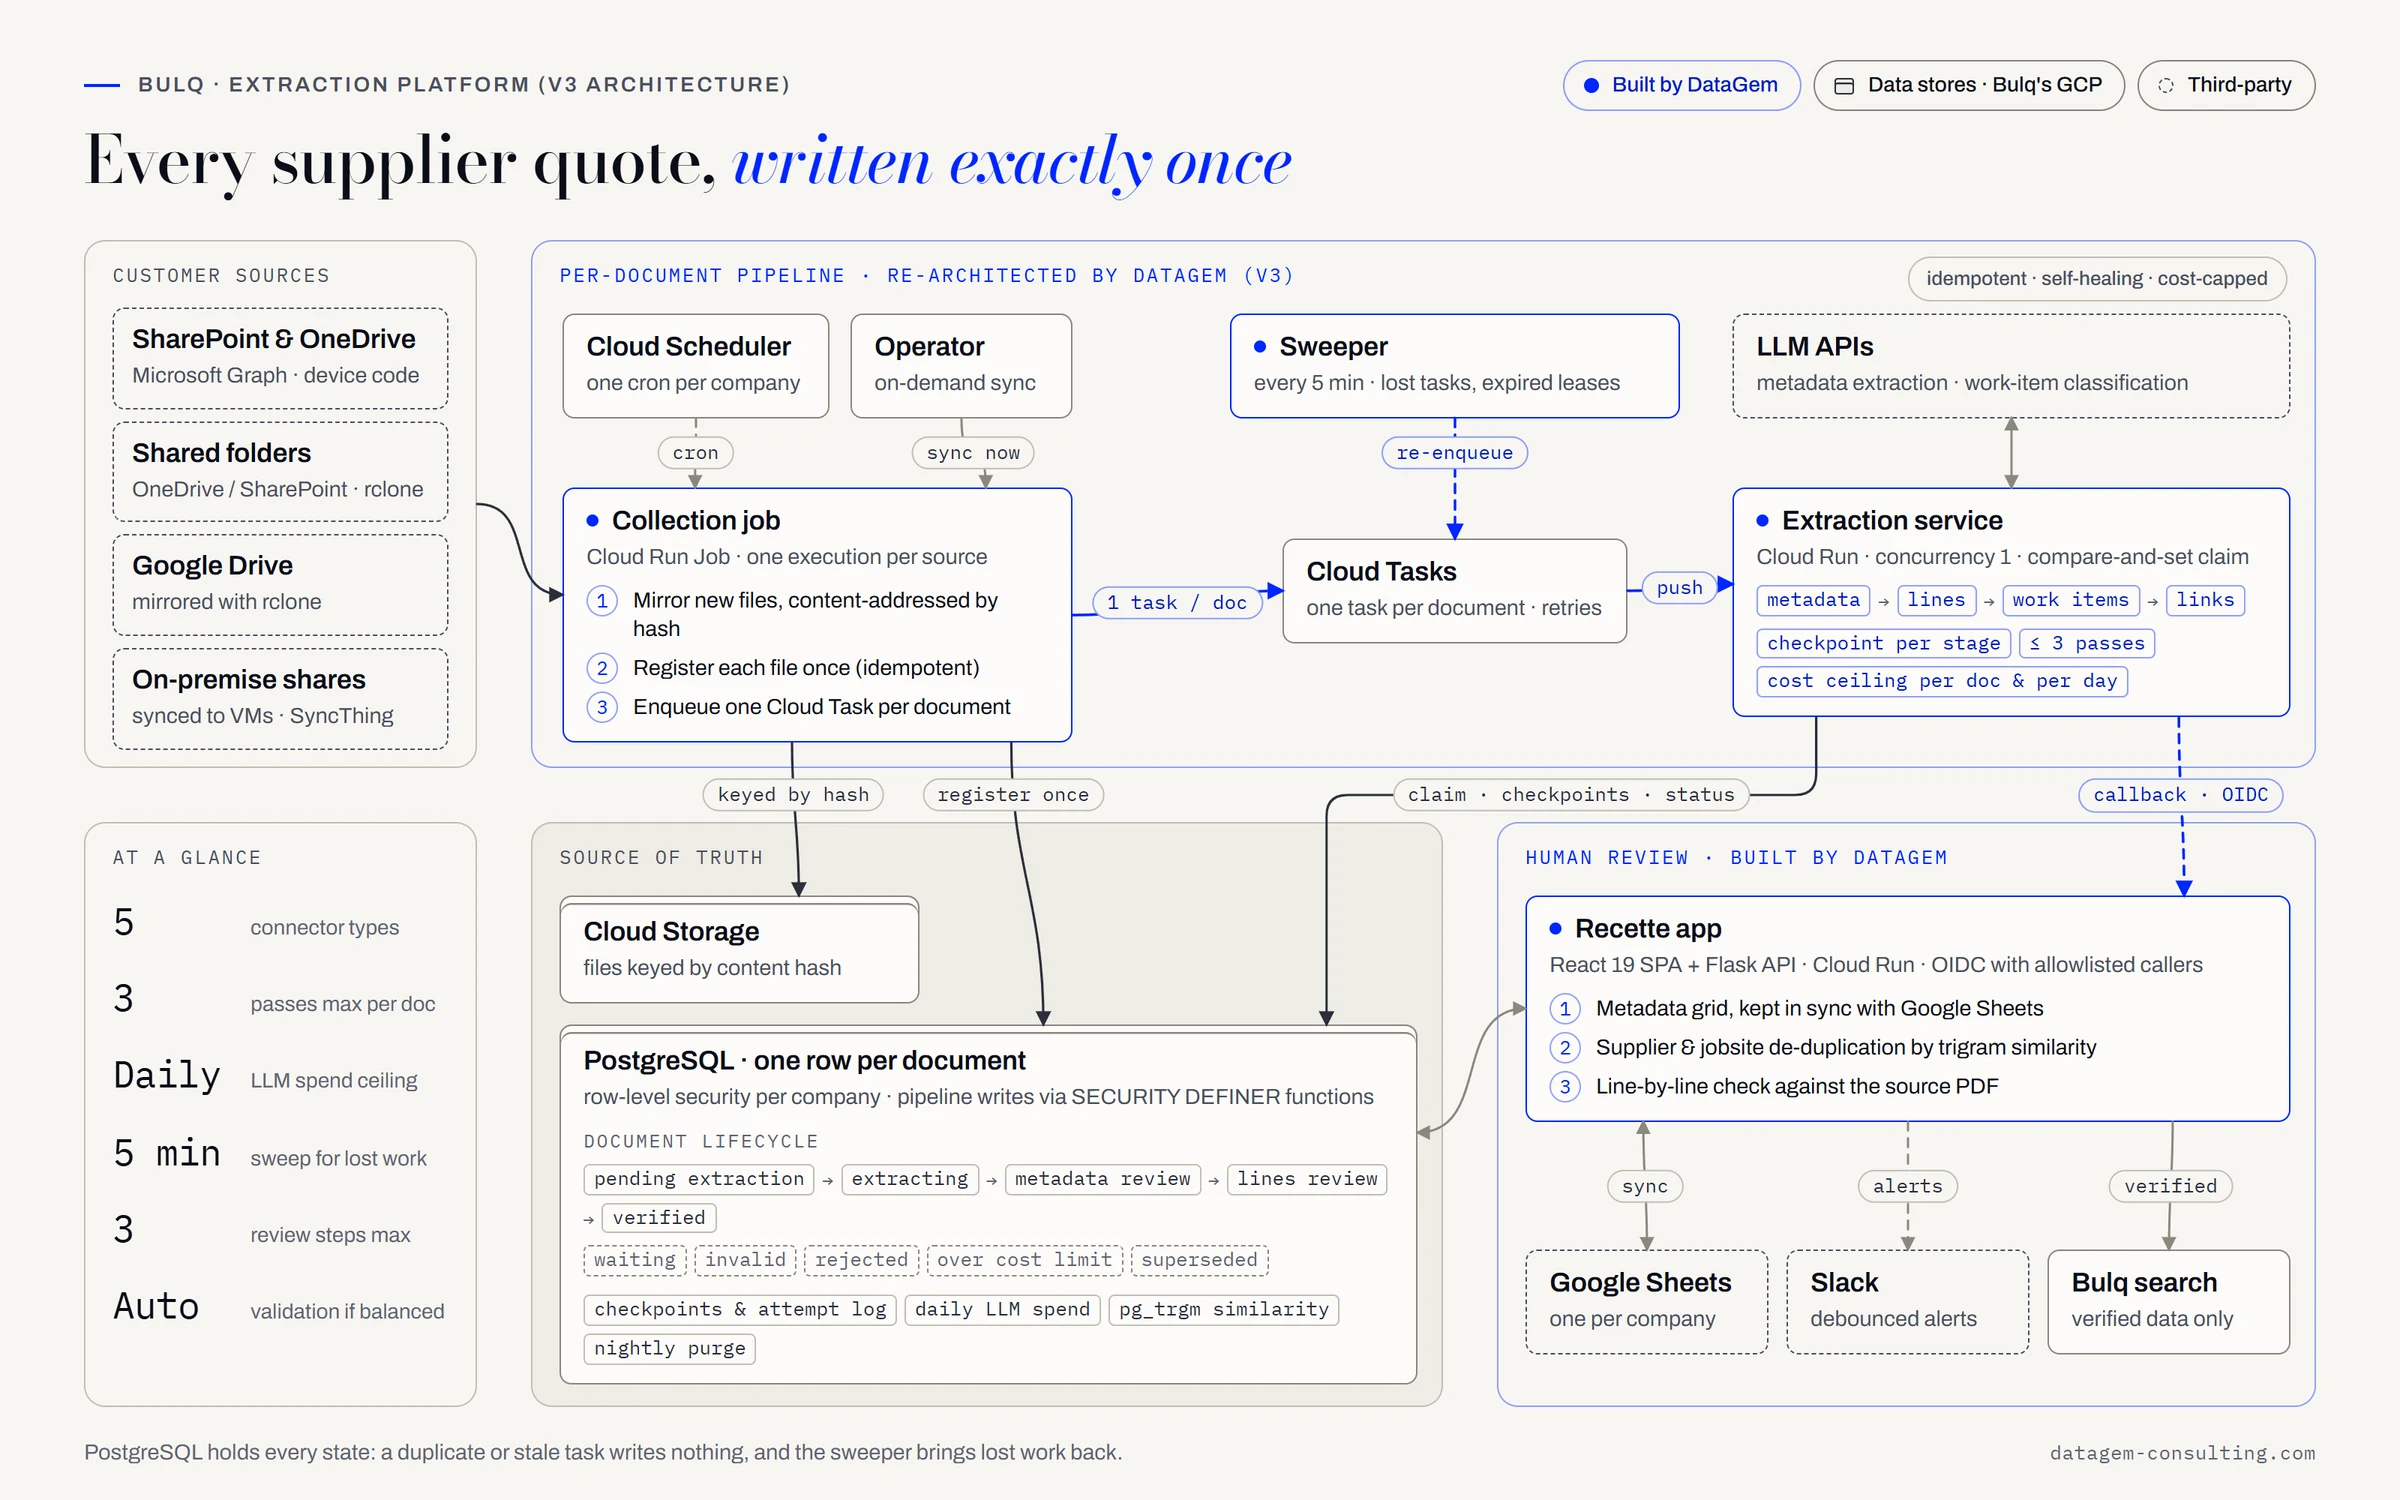
- PostgreSQL comme source de vérité unique pour le cycle de vie de chaque document : chaque fichier est enregistré une seule fois par empreinte de contenu et réservé par compare-and-set, si bien qu’une tâche en double ou périmée n’écrit rien.
- Des plafonds de coût LLM par document et par jour, inscrits dans les données, ainsi que des verrous à durée limitée (leases) et une tâche de rattrapage toutes les cinq minutes qui récupèrent le travail perdu.
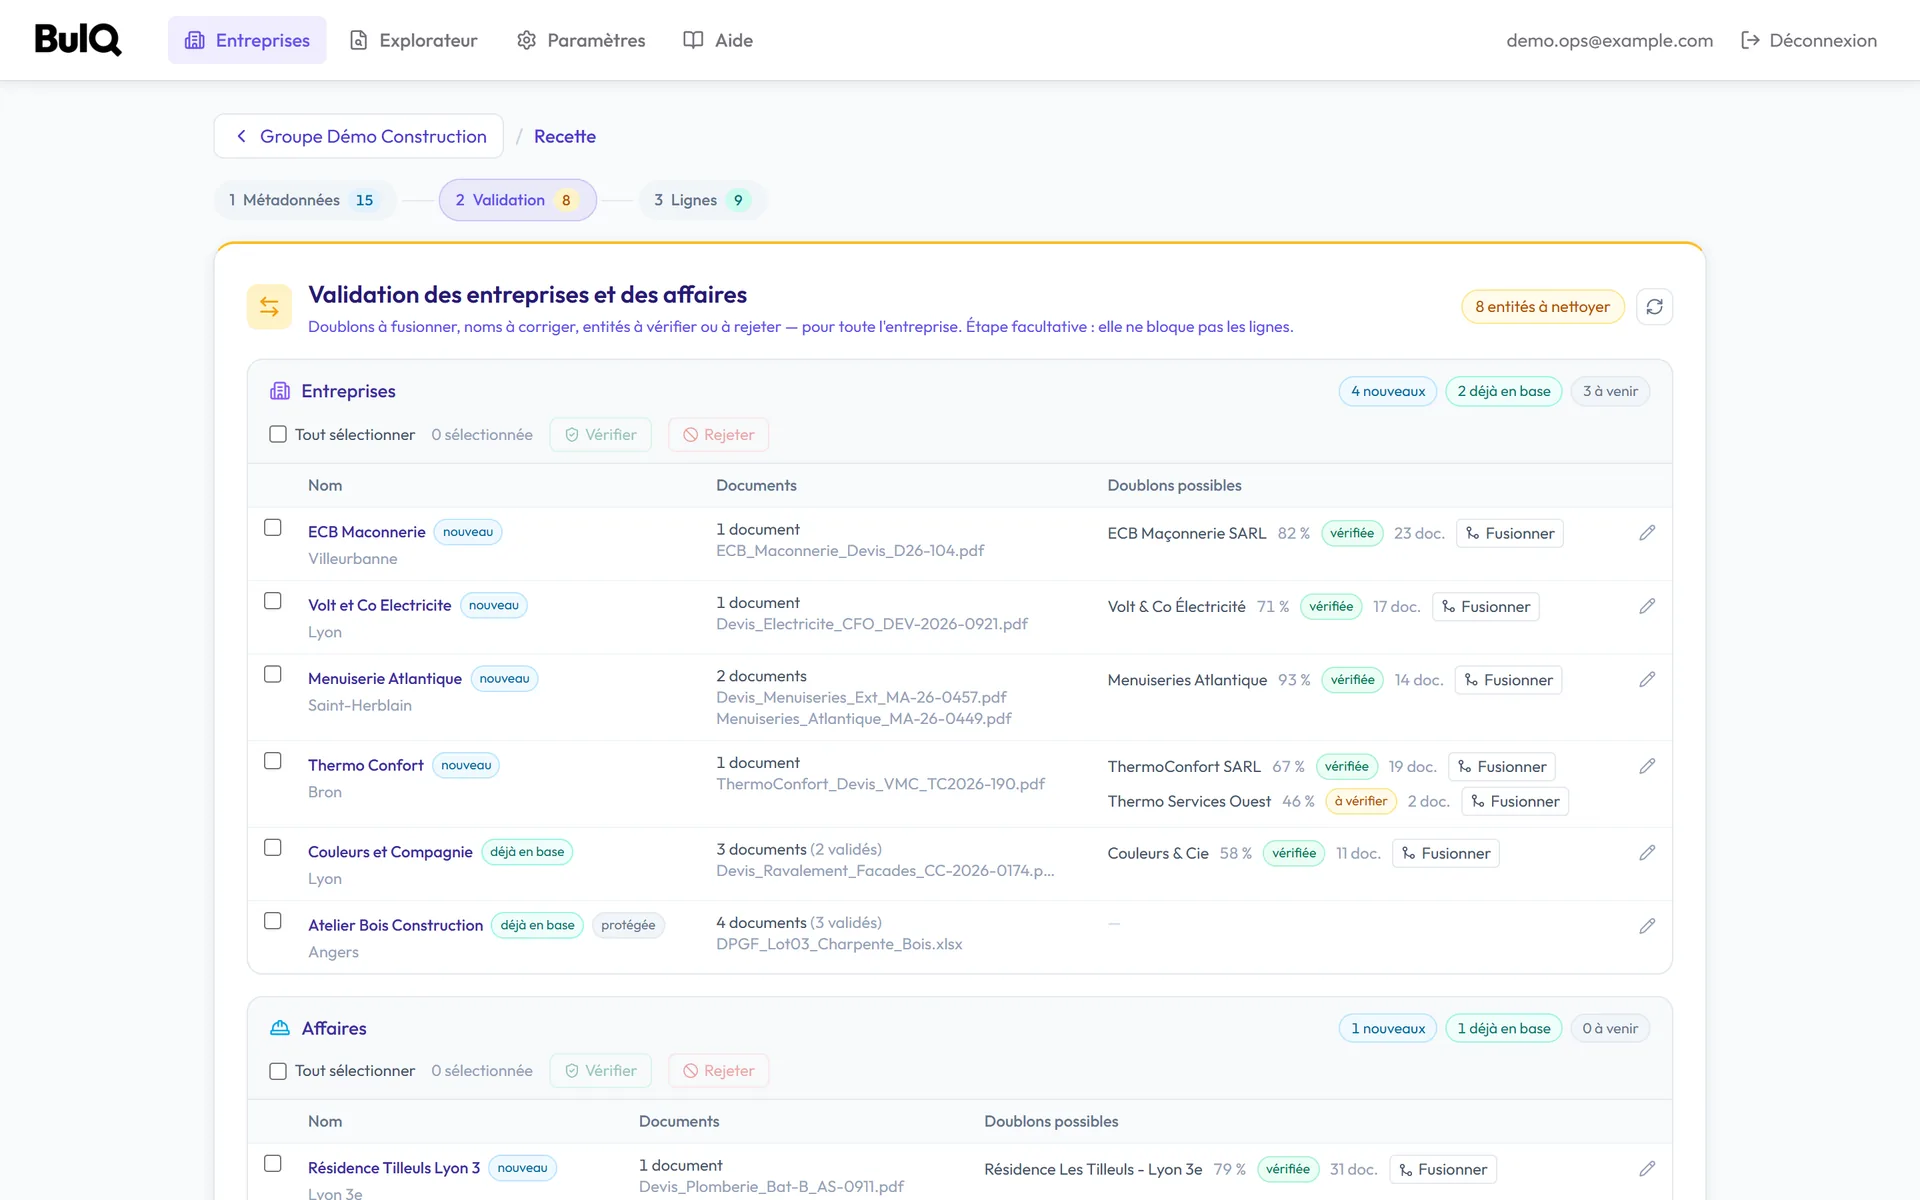
- Une résolution d’entités pour les fournisseurs et les chantiers par similarité de trigrammes, et une grille de relecture synchronisée avec Google Sheets.
Ingénierie logicielle
- Une API Flask d’extraction testée et une application React de validation humaine en trois étapes au plus ; les devis dont les lignes tombent juste sont validés automatiquement.
- Les fondations d’un backend-for-frontend FastAPI : authentification par cookies httpOnly et SSO entreprise (l’équipe de Bulq.ai a depuis migré la connexion vers Zitadel), autorisation par rôle et propriété des données, envoi de fichiers directement vers le stockage par URL signées, et une couche repository conçue pour que le back-end de données puisse passer de Supabase à un accès PostgreSQL direct, la configuration qu’utilisent désormais les déploiements Cloud Run.
- S2C : un back-end testé avec des machines à états explicites, un verrouillage optimiste, une outbox transactionnelle pour les e-mails et une API de portail fournisseur derrière des liens personnels hachés.
Cloud et infrastructure
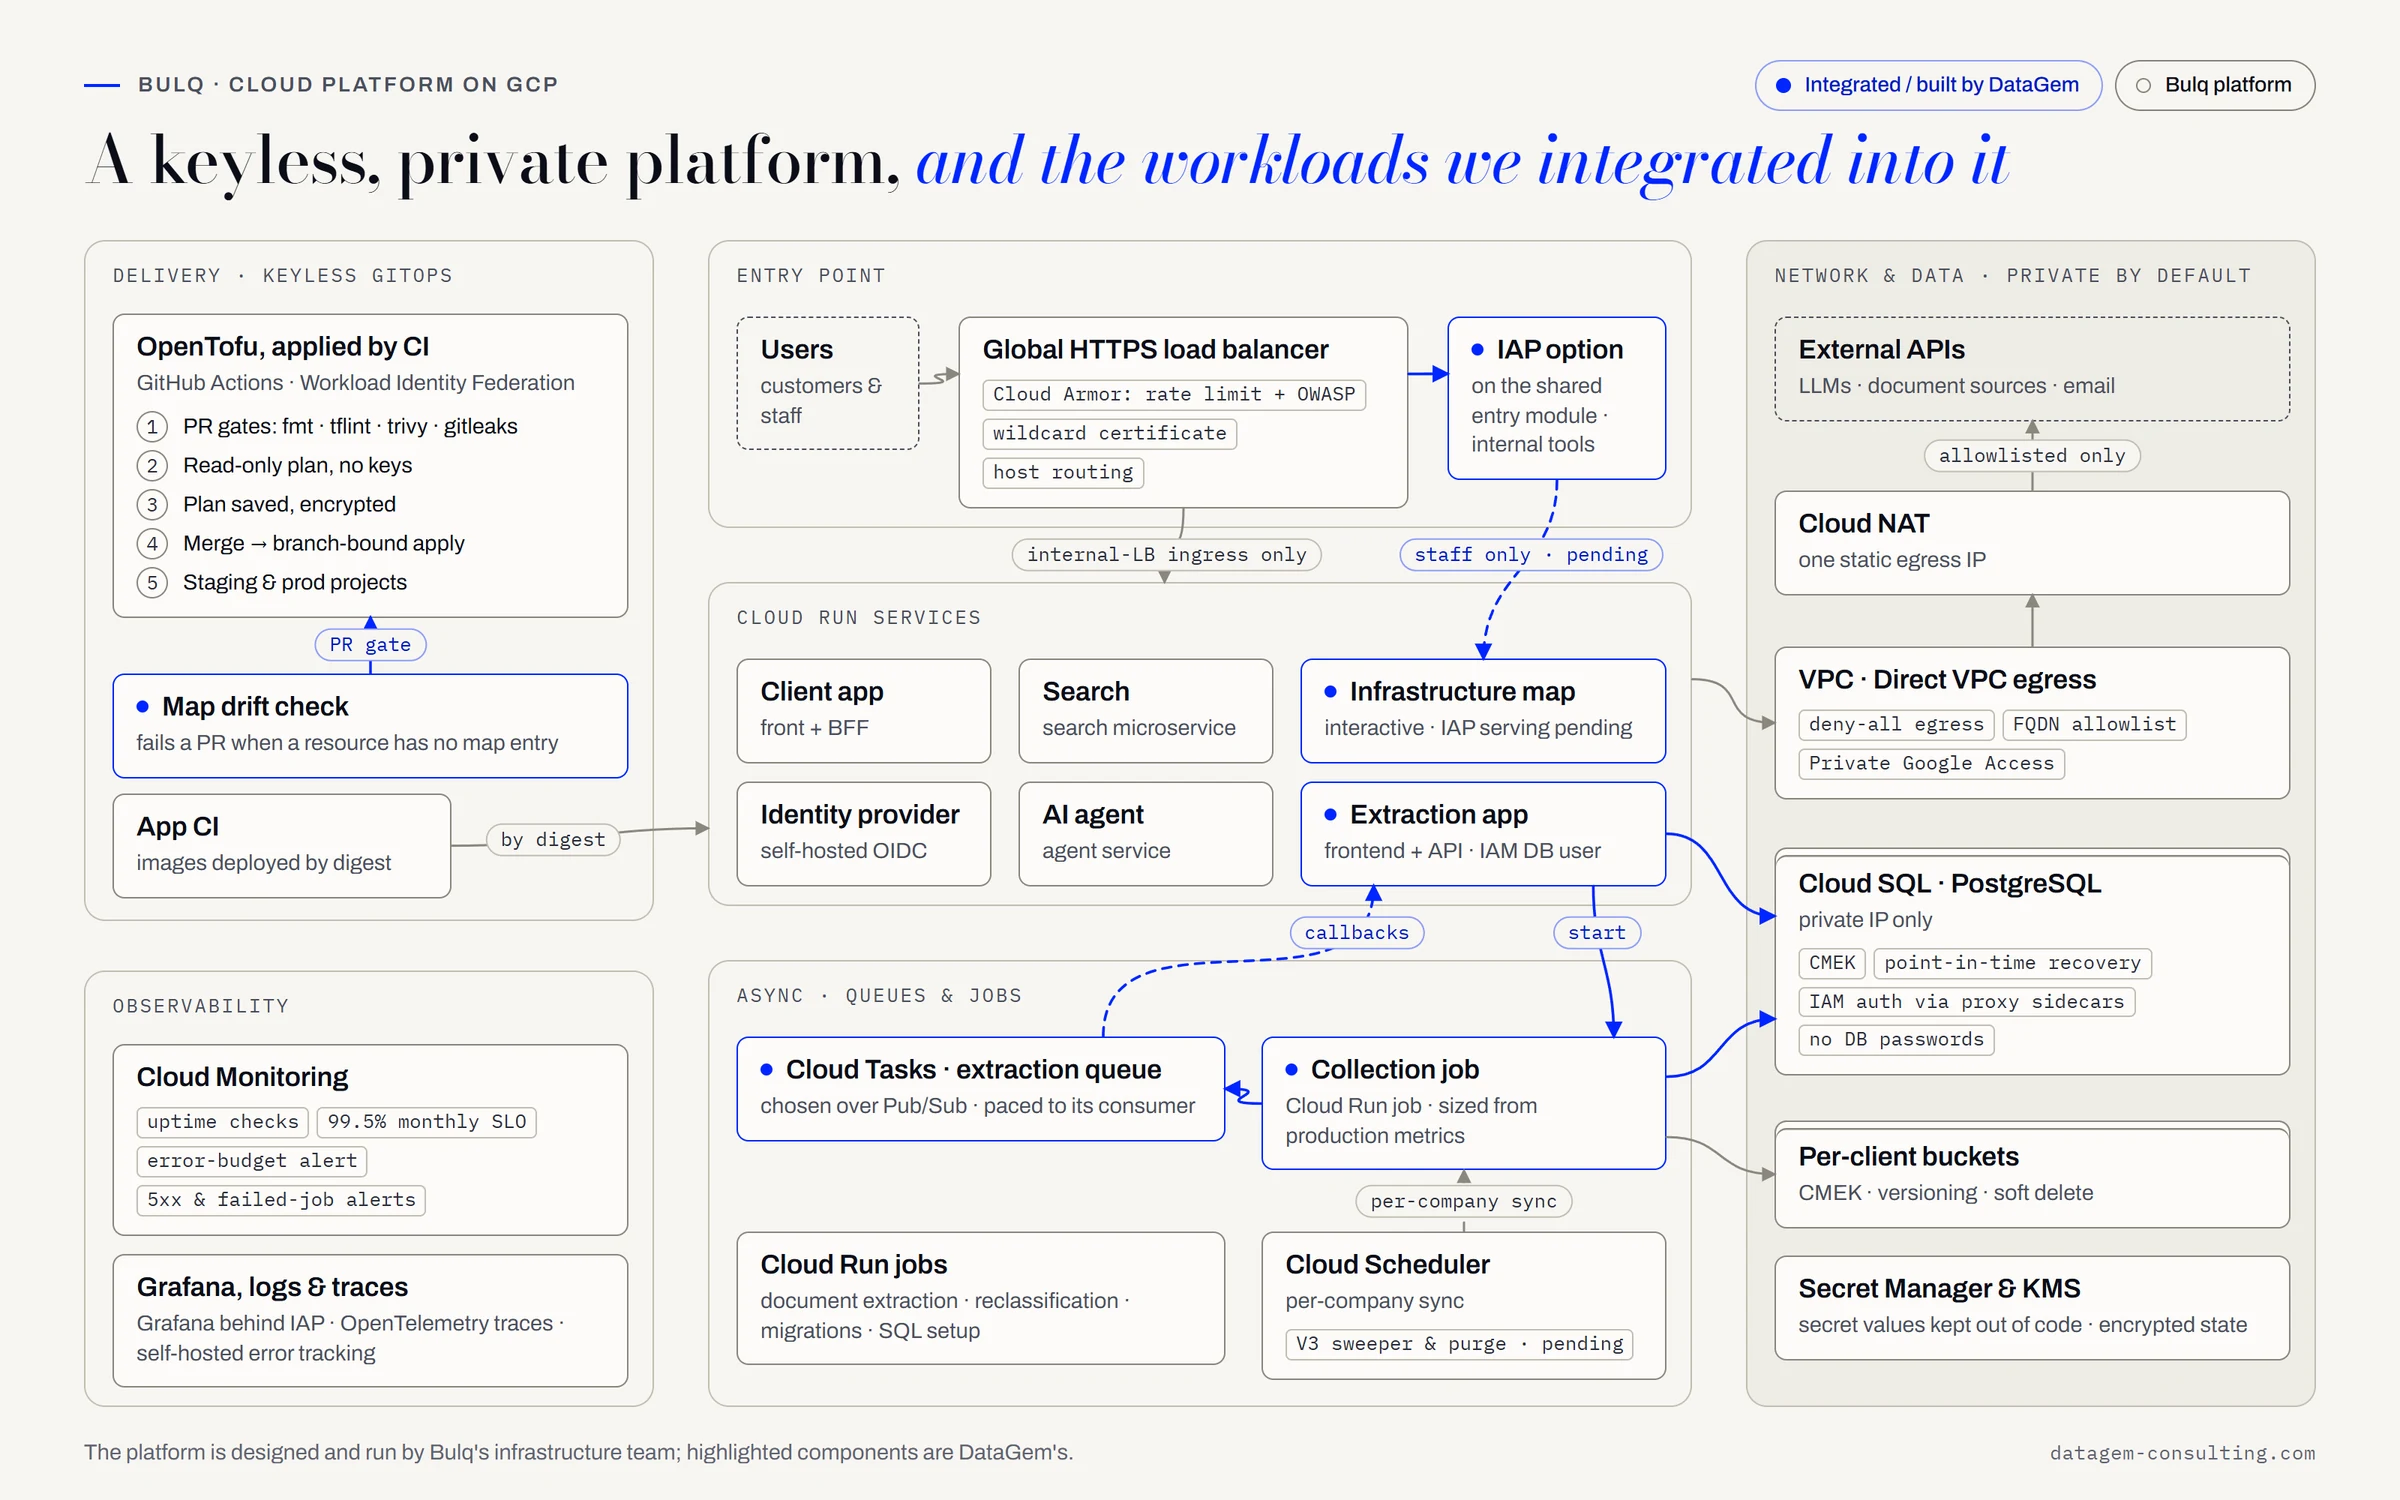
- Traitements d’extraction et de collecte intégrés à l’environnement de préproduction de la plateforme GCP de Bulq.ai, gérée en OpenTofu, avec un accès à la base de données authentifié par IAM via des proxys sidecar et des droits au moindre privilège.
- Une file Cloud Tasks cadencée au rythme de son consommateur, préférée à Pub/Sub dans une ADR (Architecture Decision Record), et un job de collecte dimensionné à partir de 30 jours de mesures en production.
- Une carte interactive de l’infrastructure, maintenue en phase avec le code OpenTofu par un contrôle de dérive en CI et prête à être servie derrière Identity-Aware Proxy.
Projet 01
Plateforme d’extraction
Flask · React · Cloud Run · Cloud Tasks · LLM
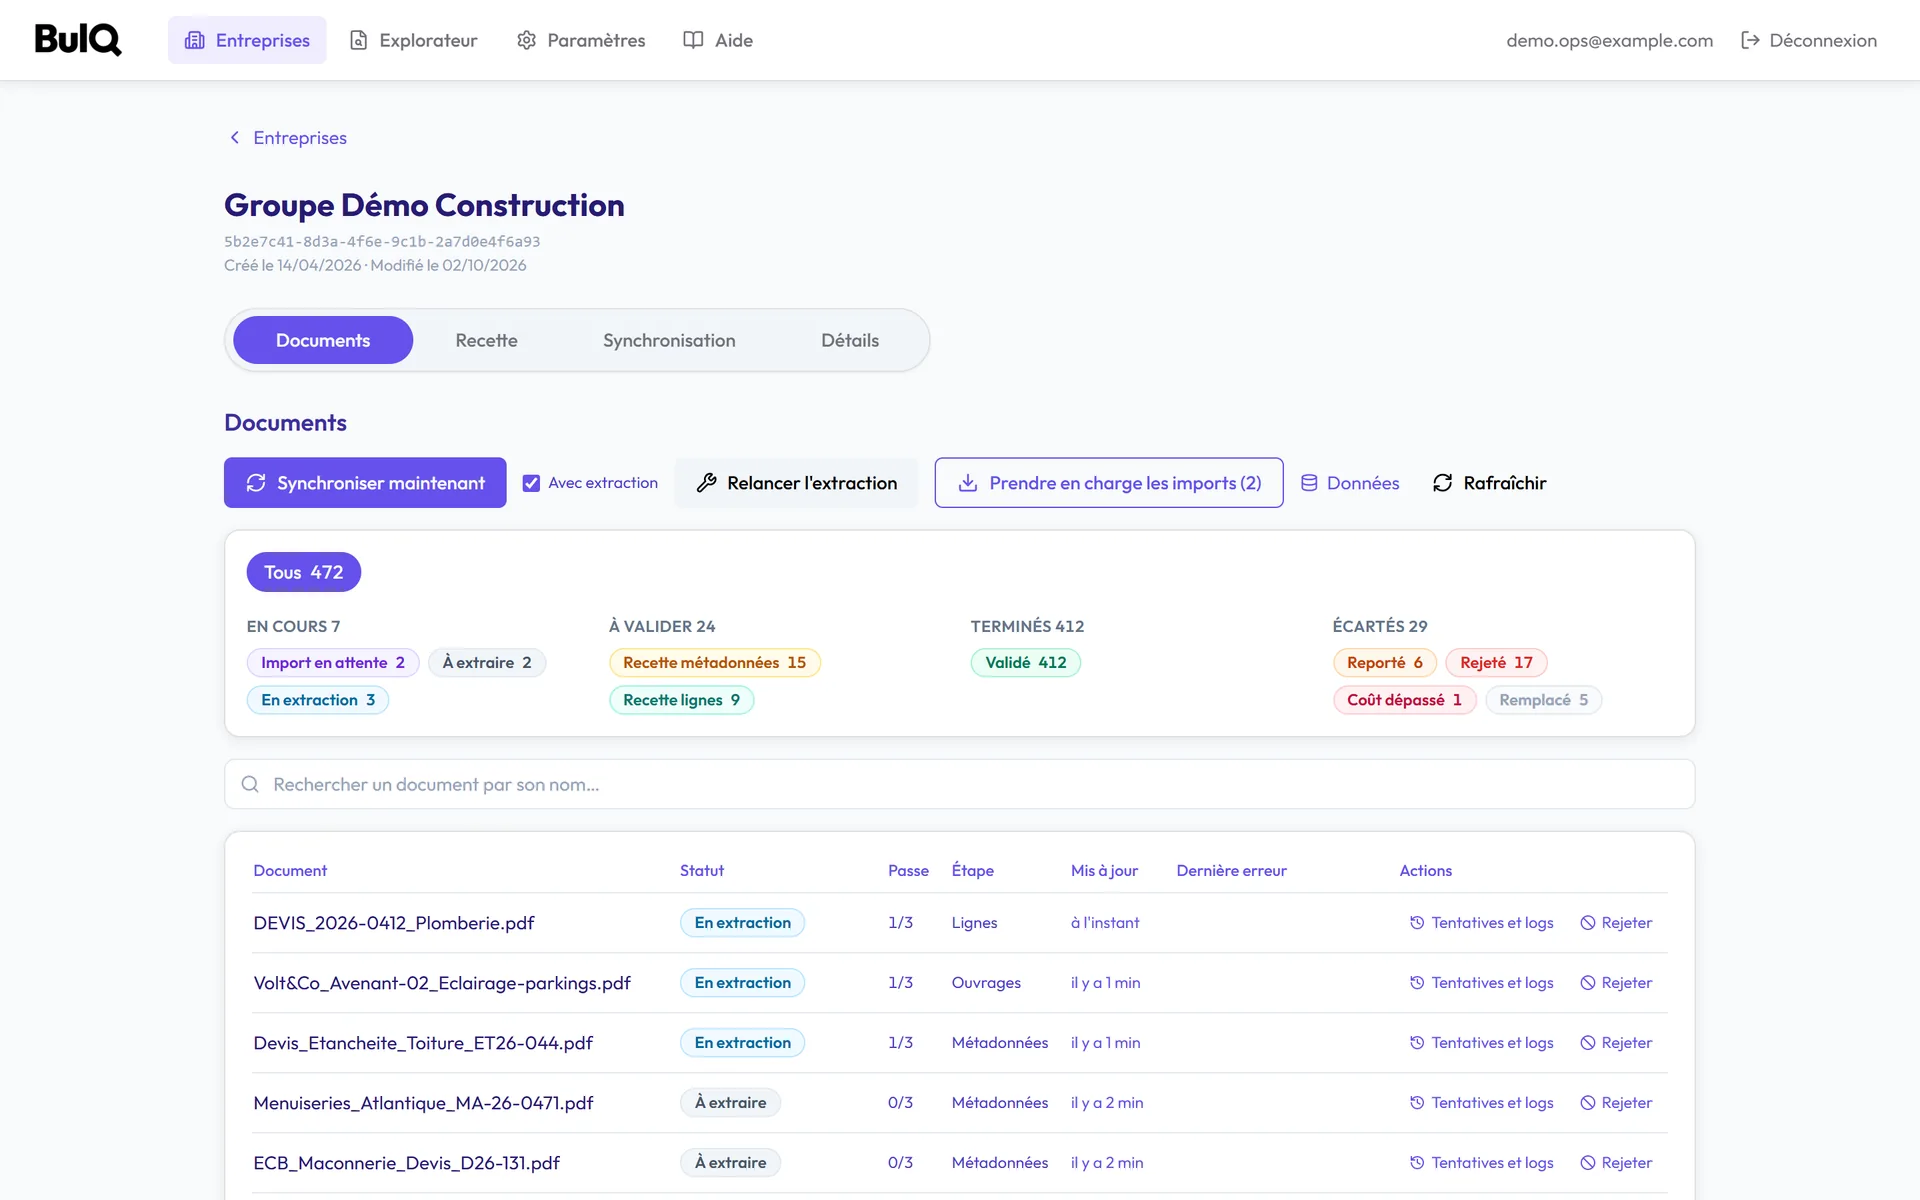
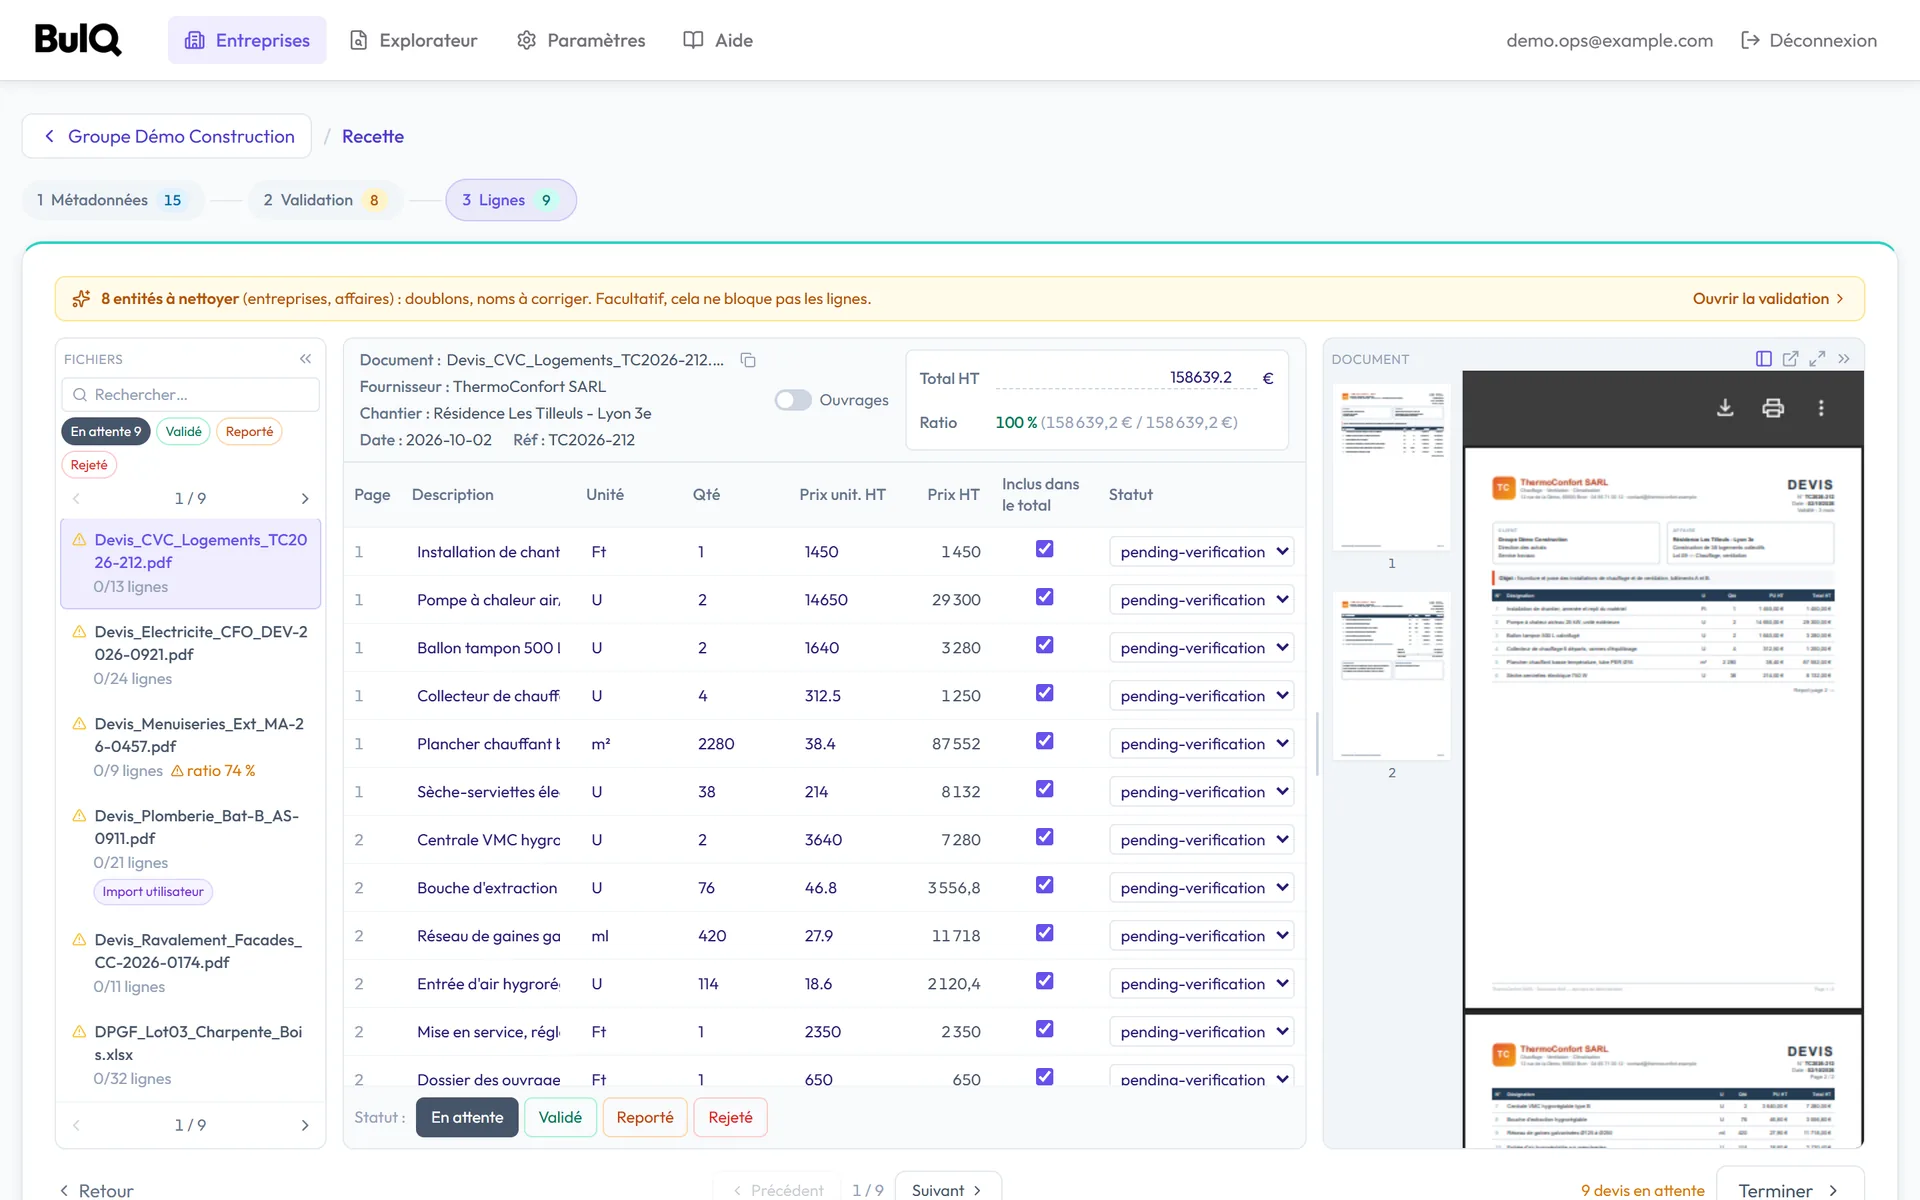
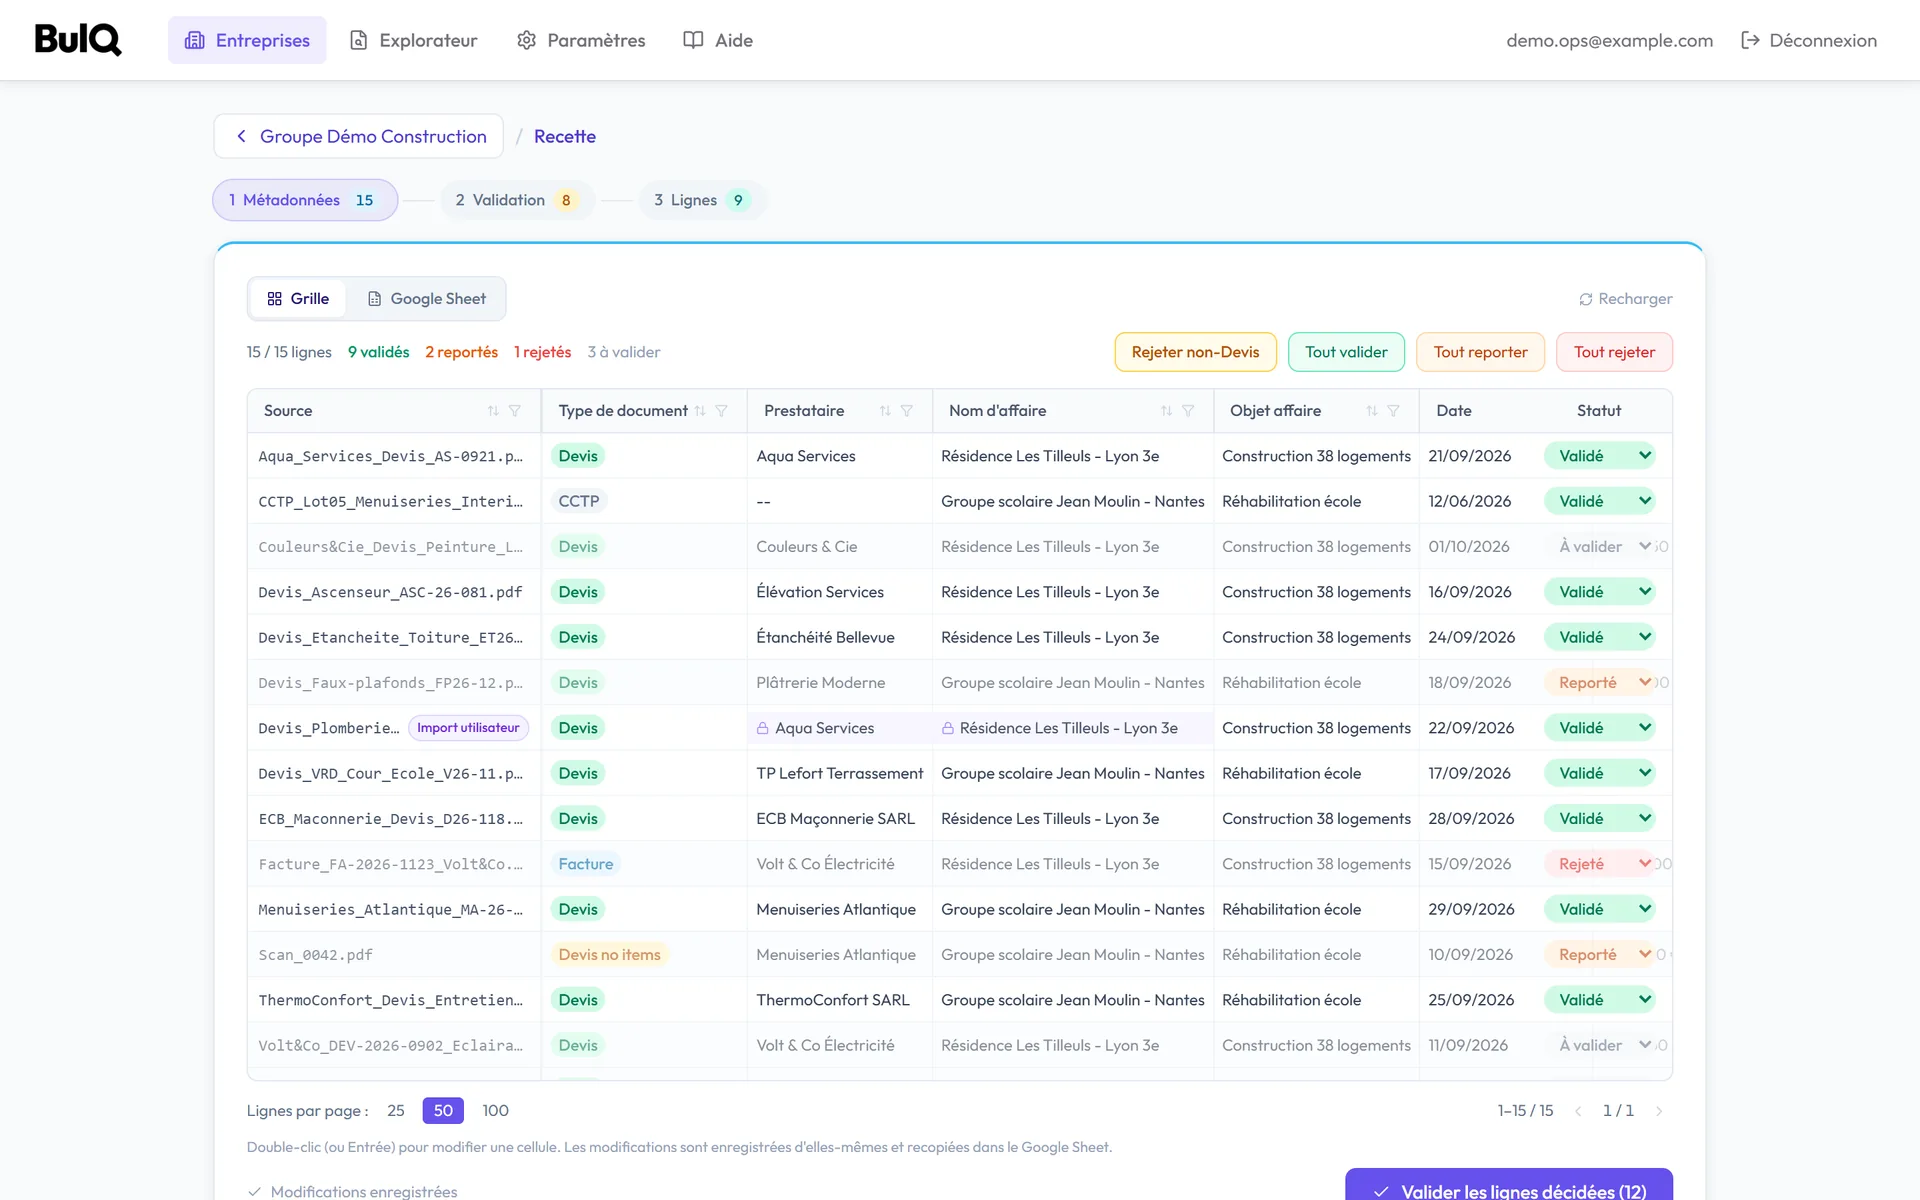
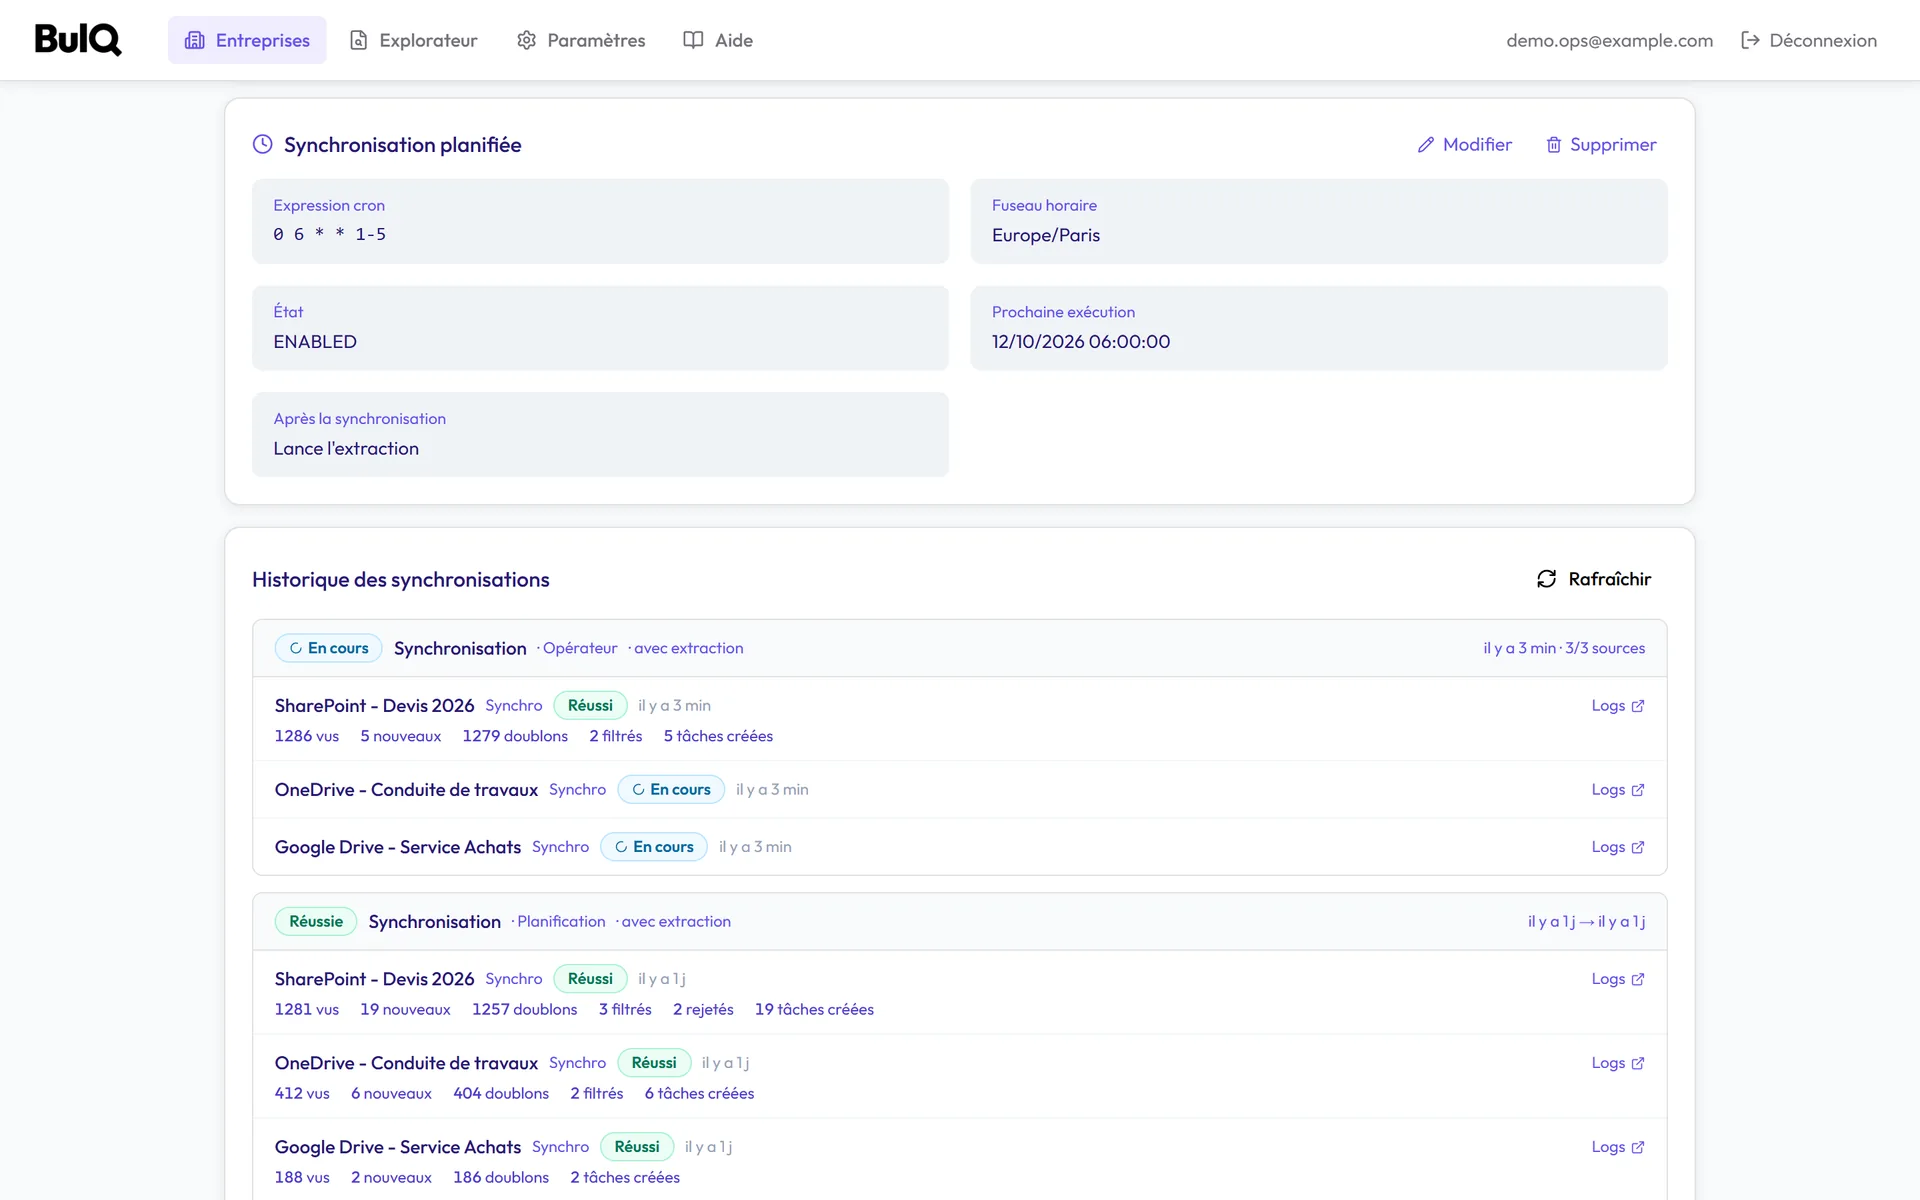
L’application d’exploitation derrière les données de Bulq.ai. Elle se connecte au SharePoint, au OneDrive, au Google Drive ou aux partages réseau sur site de chaque client, lance des synchronisations planifiées ou à la demande, suit chaque devis pendant l’extraction par LLM et le soumet à une validation humaine, en trois étapes au plus, avant qu’il n’arrive dans la recherche. DataGem en a écrit la quasi-totalité, puis a refondu le pipeline (la V3, présentée ici, développée et testée avant son déploiement) autour de PostgreSQL comme source de vérité unique.
- Objectif
- Industrialiser le traitement de milliers de devis fournisseurs aux formats hétérogènes, pour que seules des données vérifiées arrivent dans la recherche.
- Points clés
- Une tâche Cloud Tasks par document, réservation par compare-and-set et jusqu’à trois passes par fichier
- Plafonds de coût LLM par document et par jour
- Doublons de fournisseurs et de chantiers suggérés par similarité de trigrammes
- Validation ligne par ligne à côté du document source
- Technologies
- Python
- Flask
- React 19
- PostgreSQL + RLS
- Cloud Tasks
- Cloud Run Jobs
- API Google Sheets
Projet 02
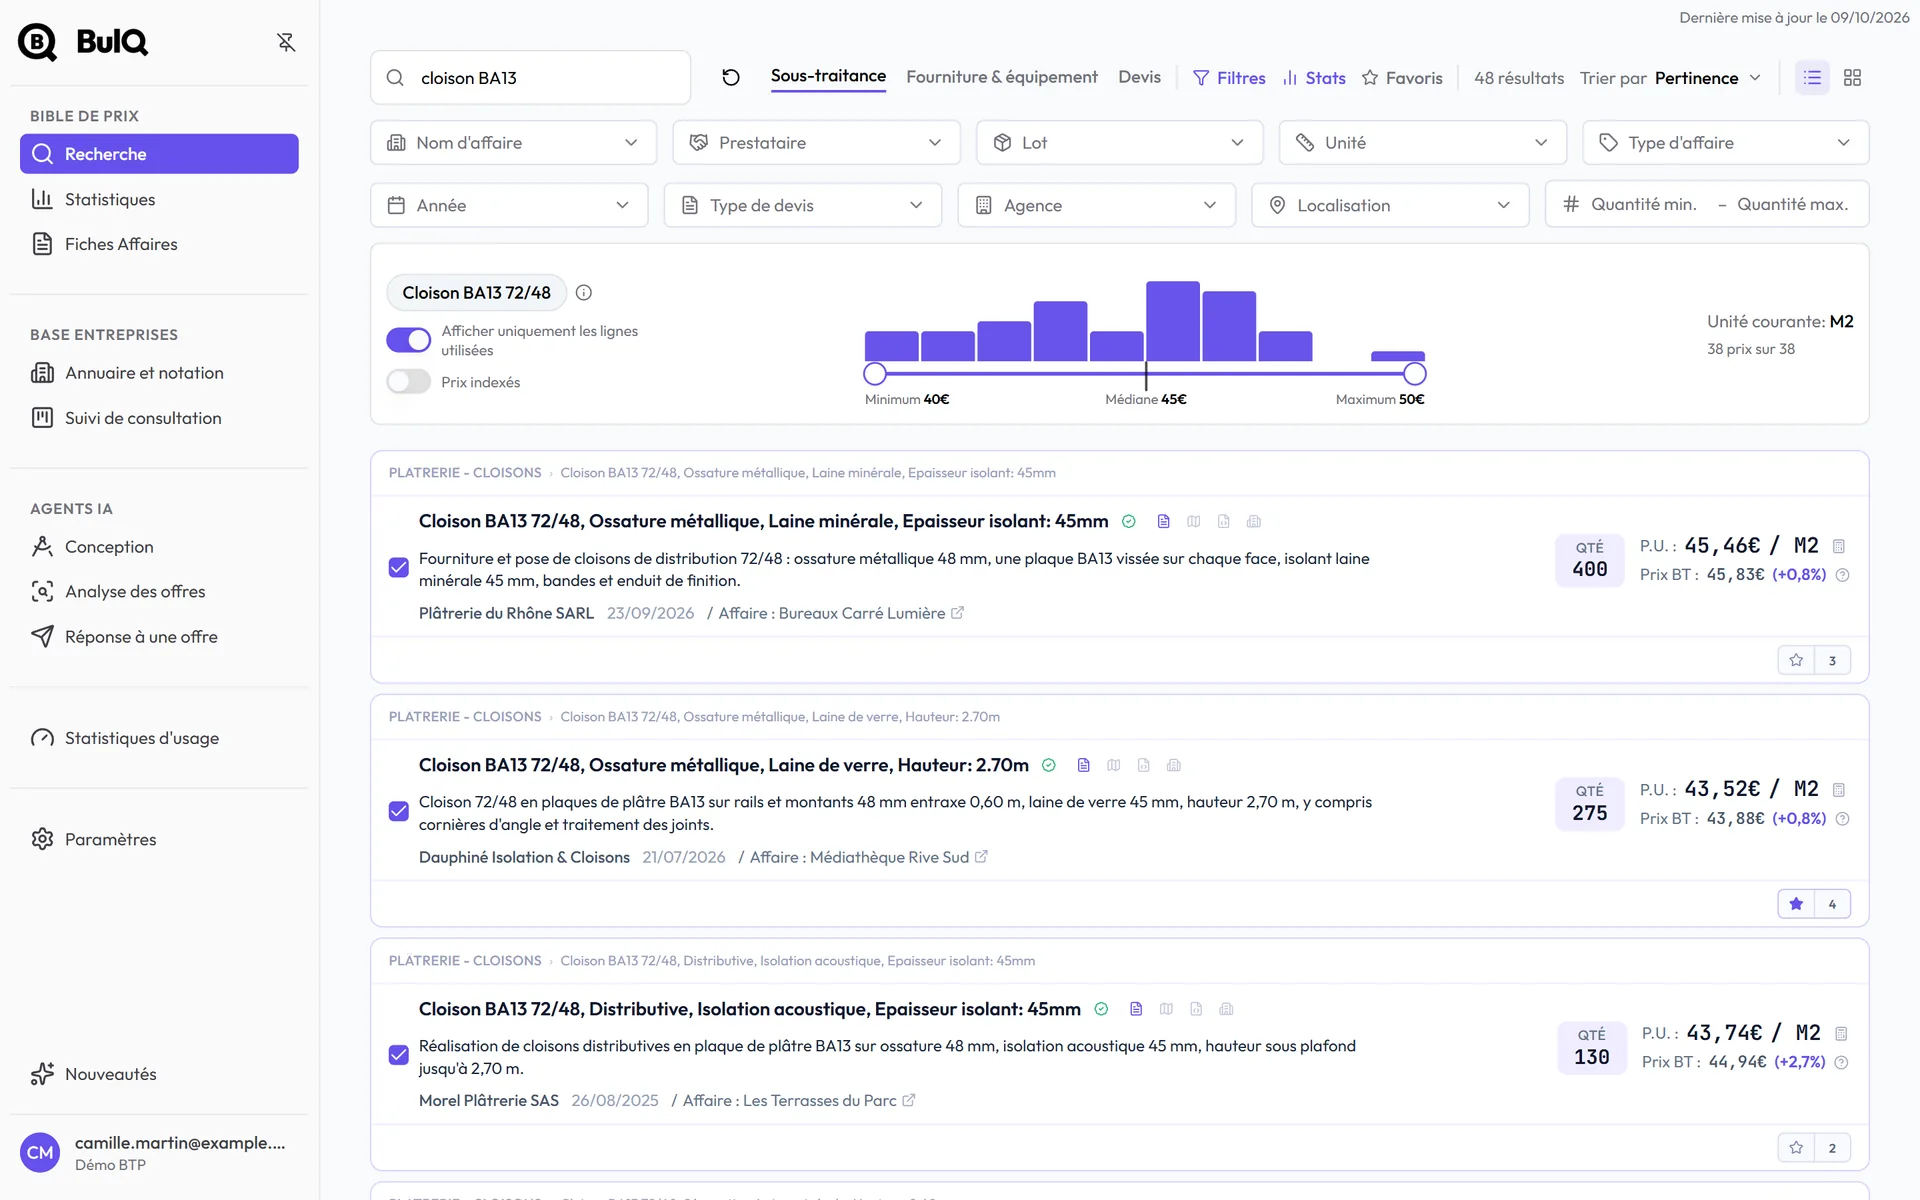
Application principale : de WeWeb à FastAPI
Backend-for-frontend FastAPI (front Next.js par l’équipe de Bulq.ai)
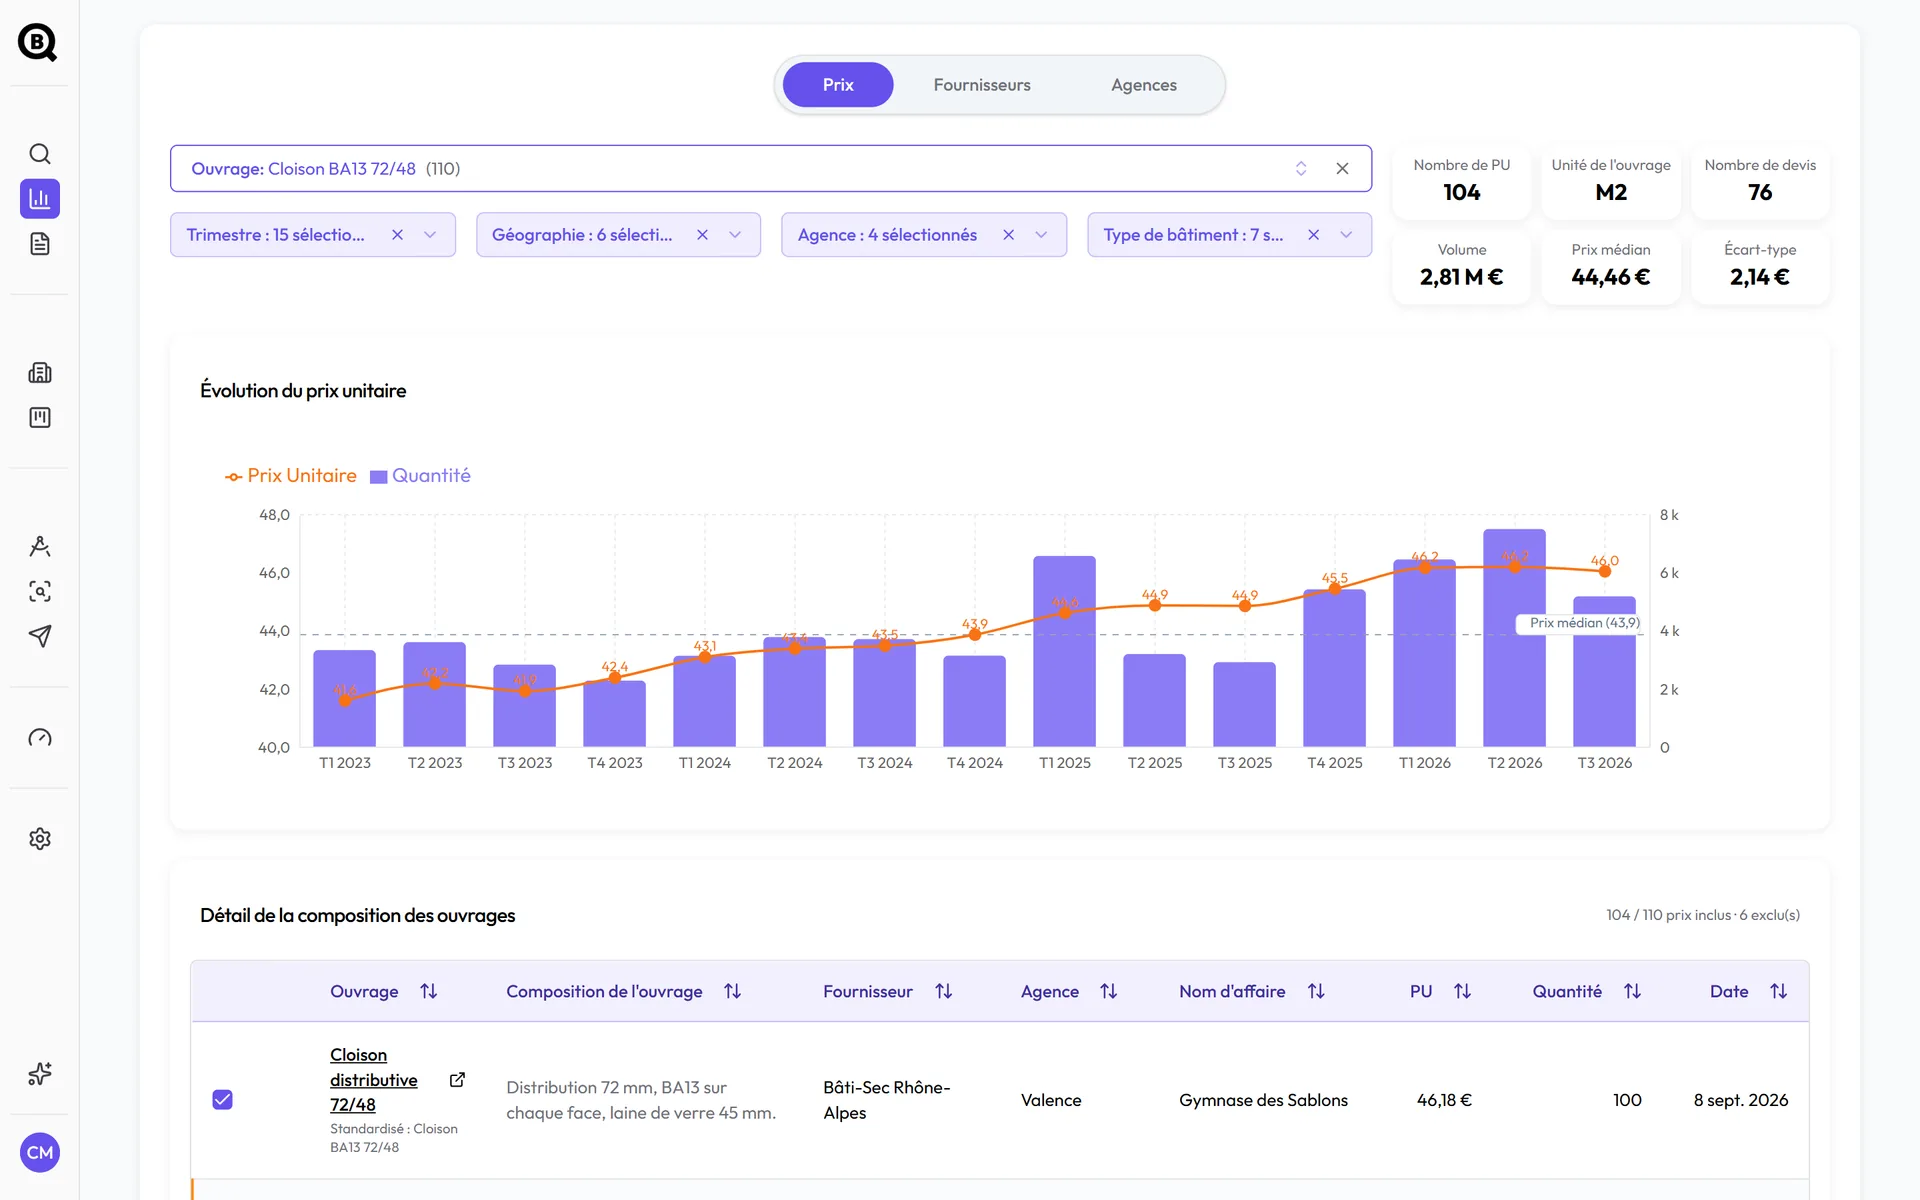
DataGem a conçu et développé les fondations du backend-for-frontend de la nouvelle application React de Bulq.ai : un proxy d’authentification qui gardait les jetons dans des cookies httpOnly, avec SSO SAML entreprise (l’équipe de Bulq.ai a depuis migré la connexion vers Zitadel) ; l’autorisation par rôle et propriété des données ; les premières API métier (statistiques de prix, chantiers, devis, entreprises) ; l’envoi de fichiers directement vers le stockage par URL signées ; et la bascule par entreprise qui a permis aux clients de quitter l’application WeWeb un par un. L’interface Next.js est l’œuvre de l’équipe interne de Bulq.ai.
- Objectif
- Remplacer le front no-code WeWeb par une stack maîtrisée et testée, sans tout basculer d’un coup.
- Points clés
- Couche repository qui fait passer le back-end de données de Supabase à un accès PostgreSQL direct par simple configuration
- Statistiques de prix avec médiane et détection des valeurs aberrantes par écart absolu médian (MAD)
- Appels de service à service en OIDC vers le microservice de recherche
- Technologies
- Python
- FastAPI
- PostgreSQL
- Supabase
- Cloud Storage
Projet 03
S2C : consultation fournisseurs automatisée
FastAPI · PostgreSQL RLS · Cloud Tasks · Brevo
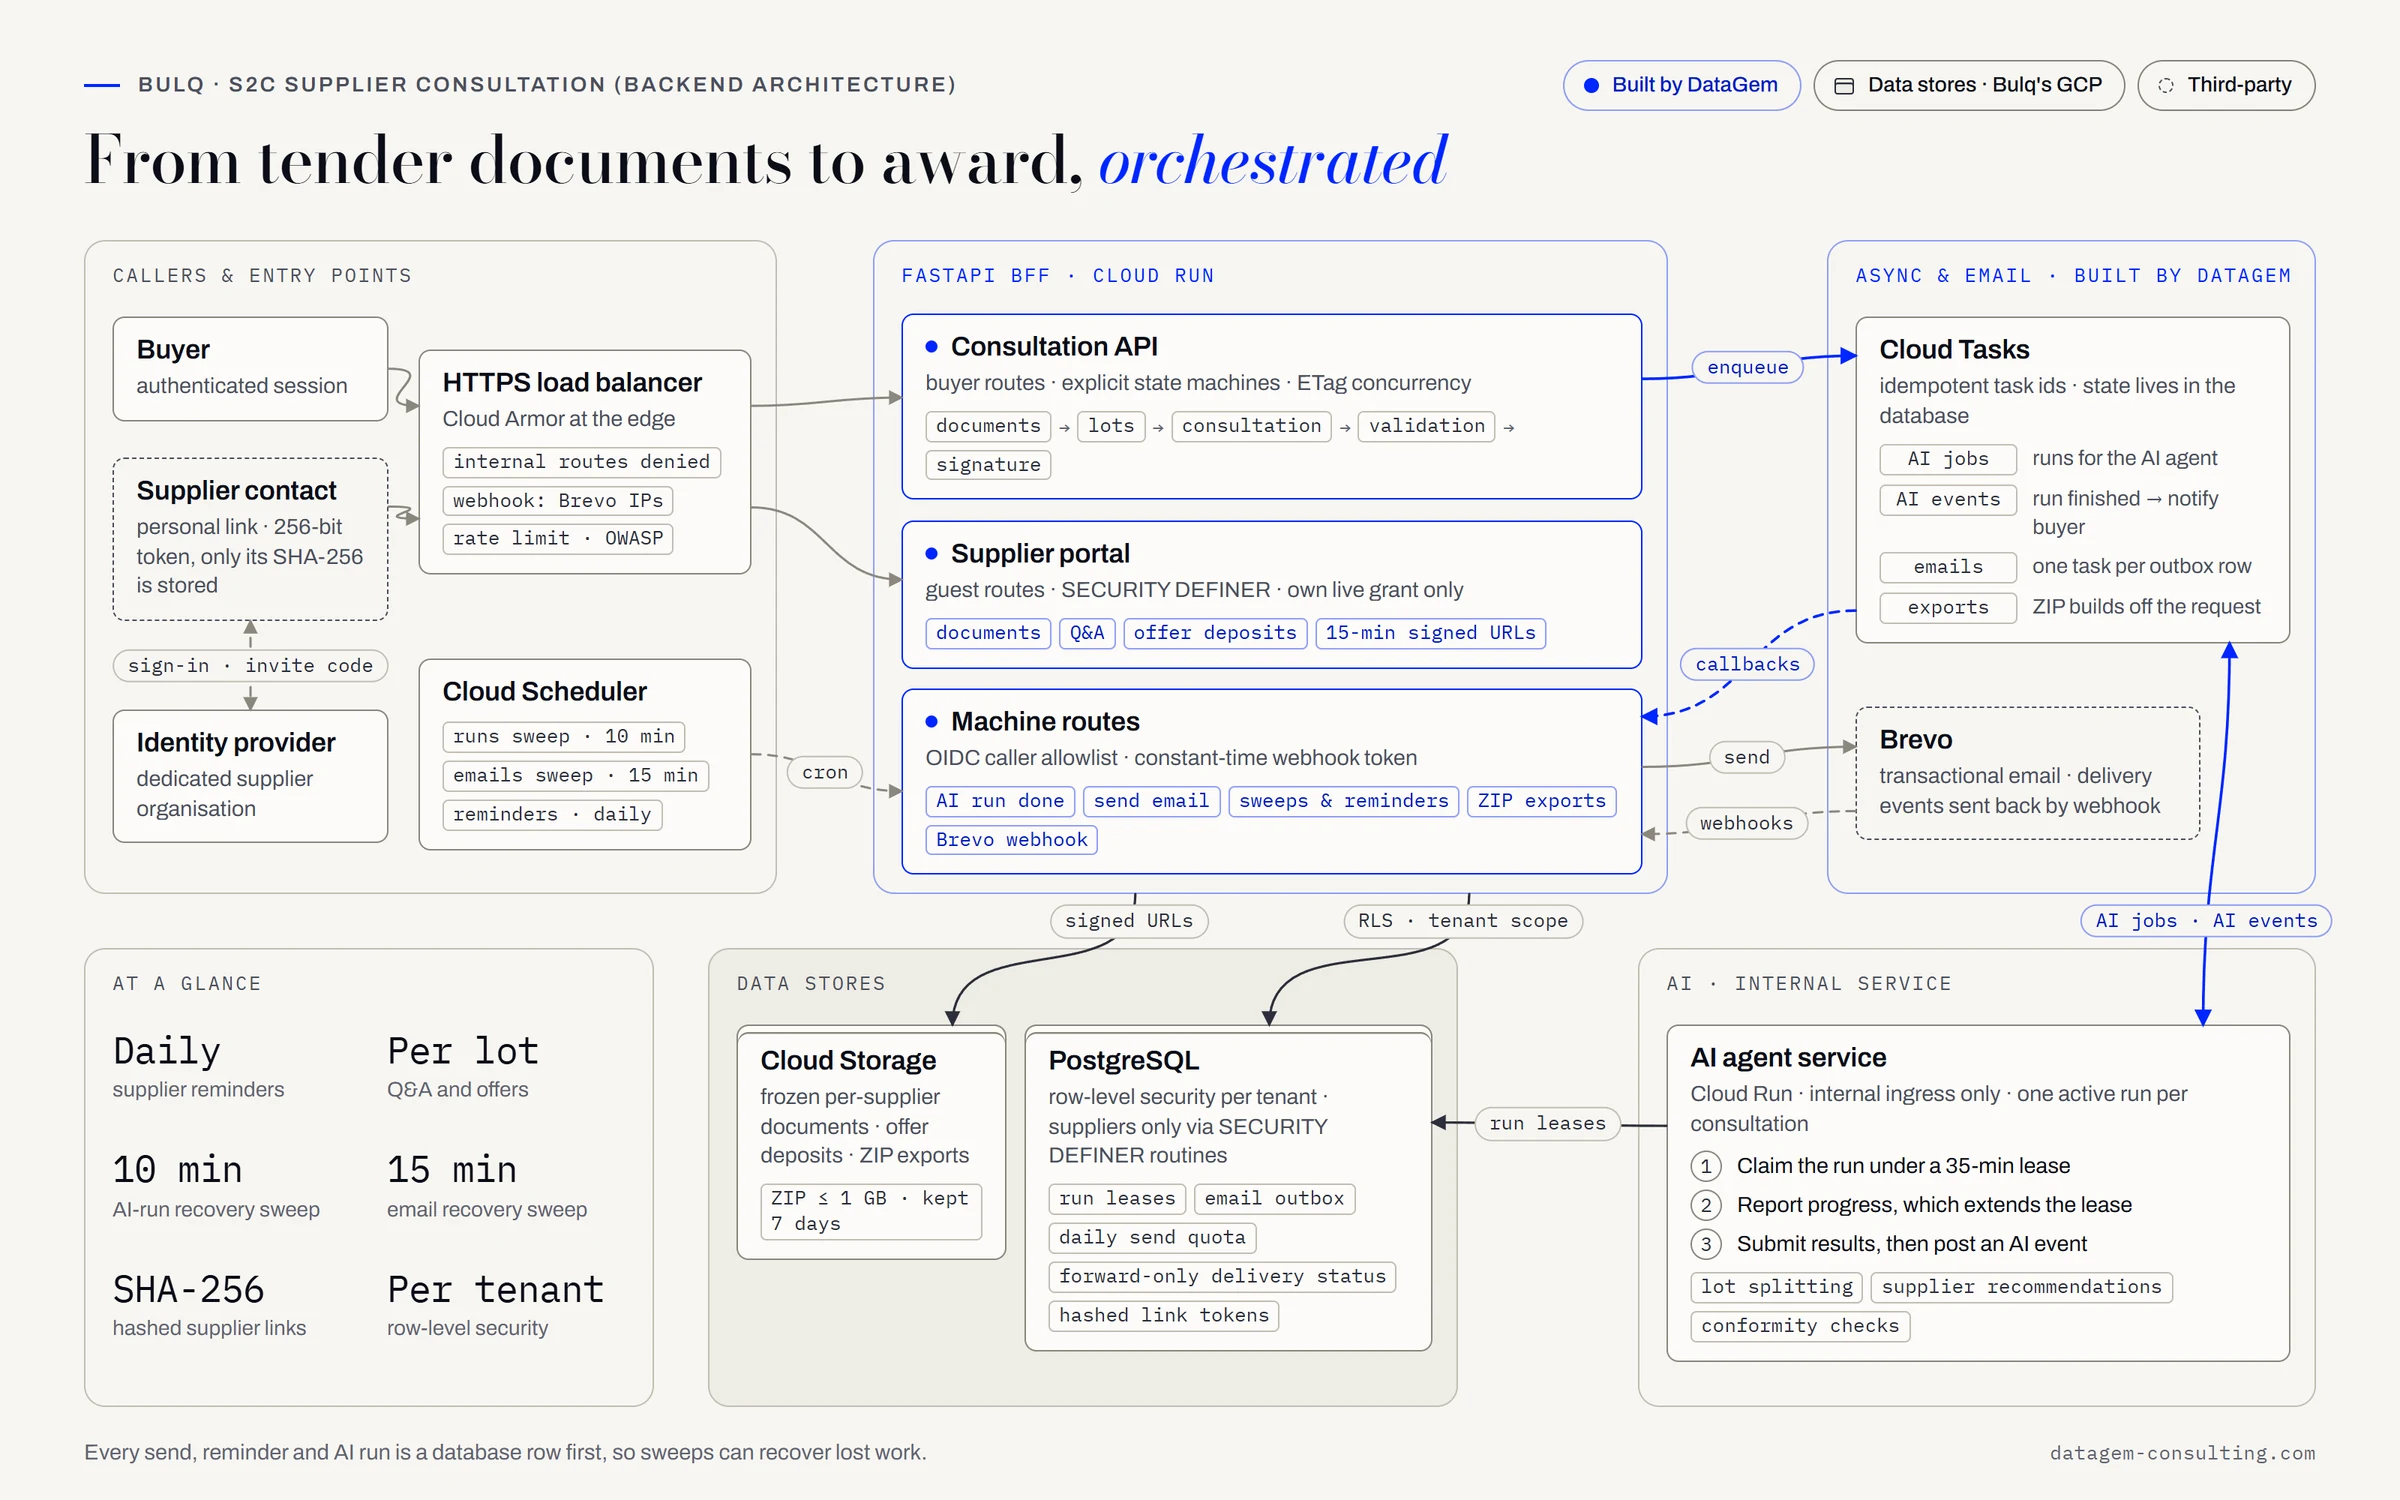
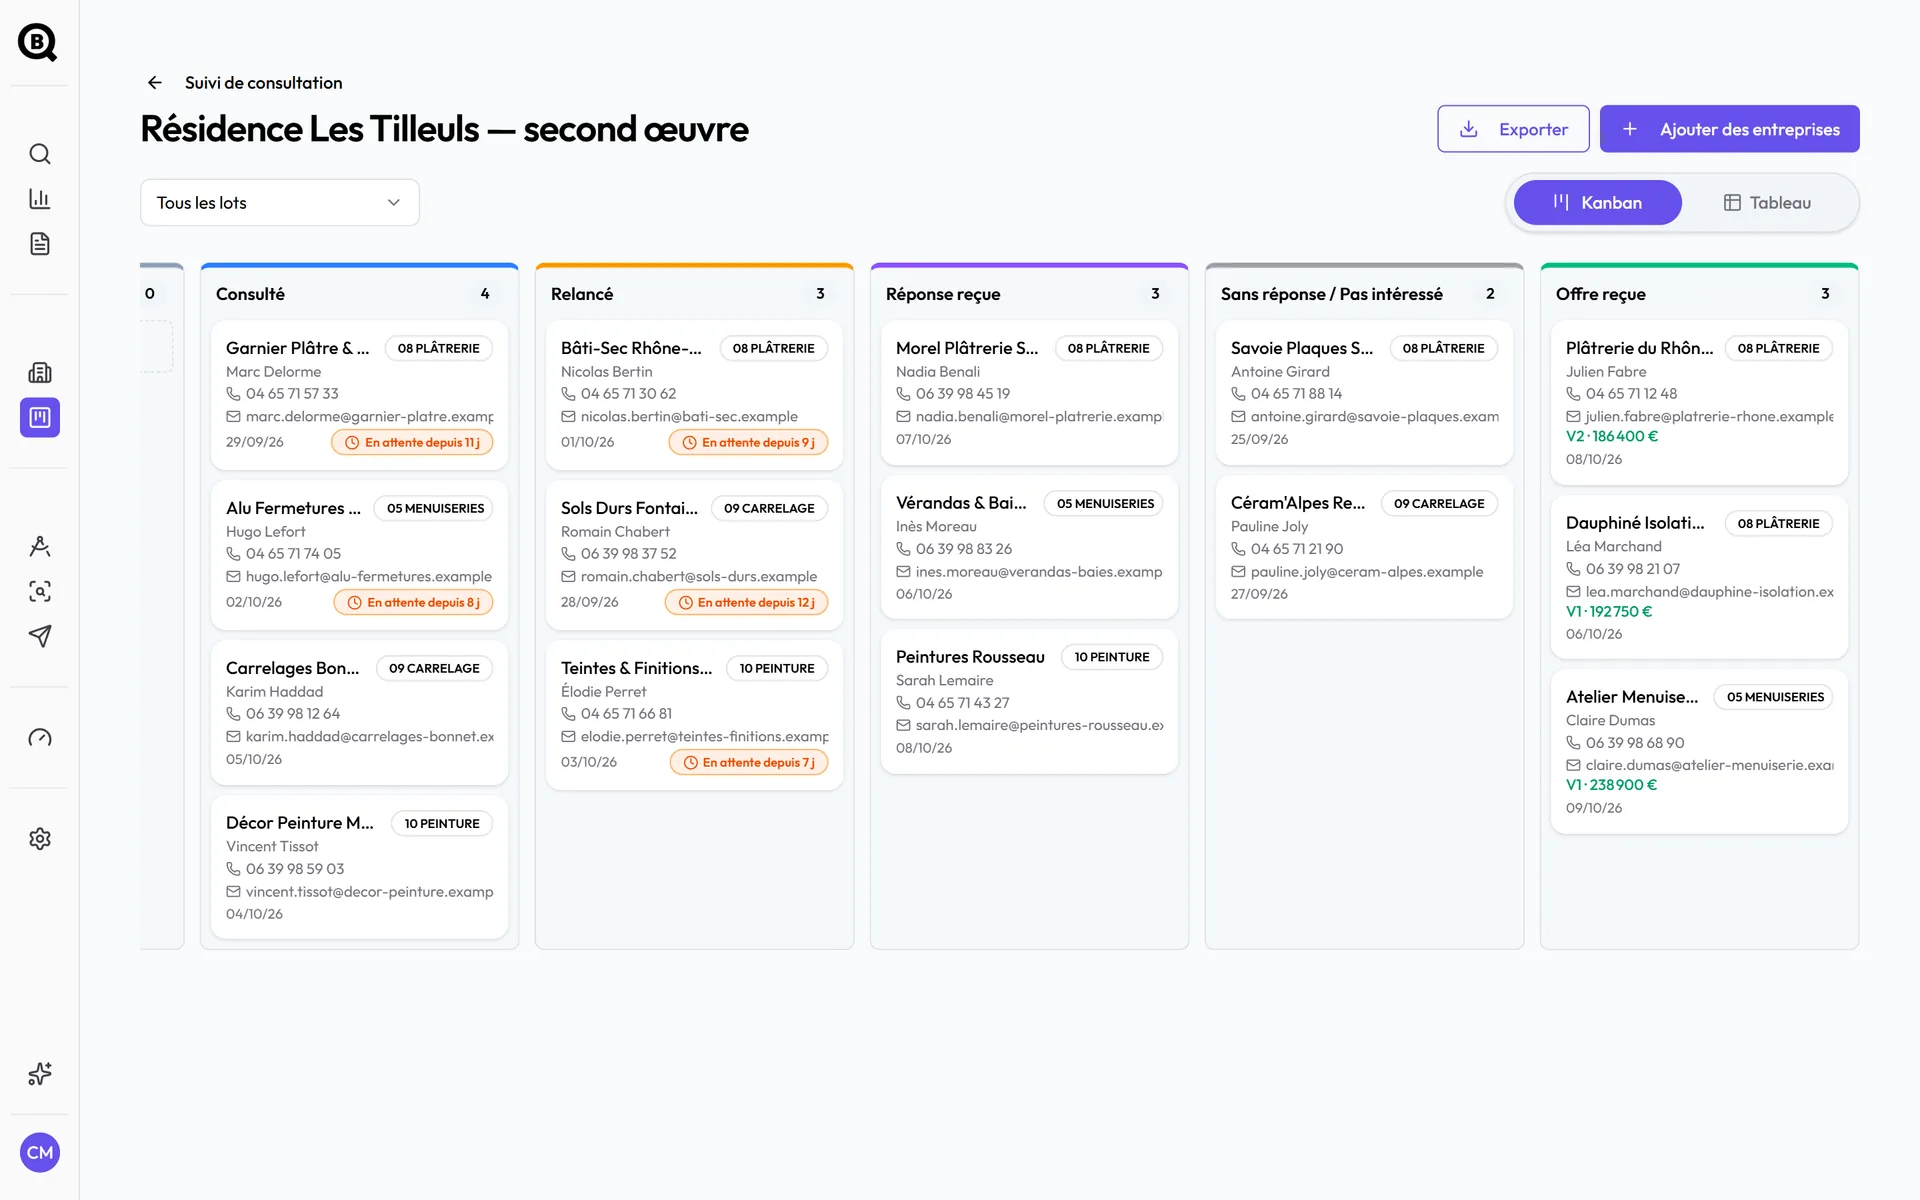
Un back-end conçu pour automatiser ce que les acheteurs suivent encore à la main : documents de consultation versionnés, allotissement par IA, recommandation de fournisseurs et analyses de conformité (exécutées par le service d’IA de Bulq.ai, orchestrées par ce back-end), invitations rédigées à partir de modèles avec liens personnels, API de portail fournisseur pour les questions et les offres par lot, comparaison des offres et attribution. Les écrans acheteur et fournisseur sont la prochaine étape.
- Objectif
- Faire passer les consultations fournisseurs d’un kanban manuel à un processus automatisé et traçable, des documents de consultation jusqu’à l’attribution.
- Points clés
- Sécurité au niveau des lignes (RLS) qui cloisonne les données de chaque tenant, l’accès fournisseur passant uniquement par des routines SQL dédiées
- Traitements IA lancés via Cloud Tasks, avec verrous à durée limitée, suivi d’avancement et tâches de rattrapage
- Outbox d’e-mails avec quota quotidien partagé et suivi de la délivrance
- Liens fournisseurs stockés uniquement sous forme d’empreintes SHA-256
- Technologies
- FastAPI
- PostgreSQL + RLS
- Cloud Tasks
- Cloud Scheduler
- Brevo
- Cloud Storage
Projet 04
Intégration à la plateforme cloud
OpenTofu · Google Cloud
L’équipe infrastructure de Bulq.ai a reconstruit son environnement Google Cloud en code OpenTofu. DataGem a intégré les traitements d’extraction et de collecte de données à son environnement de préproduction selon le même standard, sans clé et au moindre privilège, et a construit une carte interactive de la plateforme qu’un contrôle en CI maintient en phase avec le code.
- Objectif
- Faire tourner les traitements de DataGem sur la plateforme durcie du client sans l’affaiblir.
- Points clés
- File Cloud Tasks cadencée au rythme de son consommateur ; job de collecte dimensionné à partir de mesures en production
- Accès à la base de données authentifié par IAM via des proxys sidecar
- Option Identity-Aware Proxy ajoutée au module de point d’entrée partagé
- Carte de l’infrastructure vérifiée par rapport au code en CI, empaquetée pour un déploiement par digest d’image derrière IAP
- Technologies
- OpenTofu
- Cloud Run
- Cloud SQL
- Cloud Tasks
- IAP
- GitHub Actions